Der nächste KI-Meilenstein in der Produktion: Agentische KI. Das Fraunhofer IWU stellt mit Orcha-3 eine Plattform vor, die eigenständig Fehler in komplexen Prozessketten analysiert – bei voller Datensouveränität im Unternehmensnetz.
Agentische KI kann anspruchsvolle, komplexe Aufgaben übernehmen und passgenaue Lösungen vorschlagen.
(Bild: Fraunhofer IWU)
In der modernen Fertigung stoßen Instandhalter und Qualitätsmanager oft auf ein frustrierendes Phänomen: Am Ende einer mehrstufigen Prozesskette liegen Bauteile außerhalb der Toleranz, obwohl jede einzelne Station zuvor „in Ordnung“ gemeldet hat. Woher kommt die Abweichung? Meist bleiben solche Fragen unbeantwortet, weil die Klärung Tage an manueller Datenarbeit erfordern würde – Zeit, die im Industrie-Alltag fehlt.Bisherige KI-Ansätze, bei denen der Mensch über Prompts schrittweise Lösungen aus einem Sprachmodell (LLM) herauskitzelt, greifen bei derart komplexen Problemen zu kurz. Eine Lösung verspricht „Agentic AI“. Diese Technologie zerlegt hochkomplexe Fragestellungen selbstständig in Teilschritte, wählt die passenden digitalen Werkzeuge (Agenten) aus, wertet Zwischenergebnisse aus und leitet daraus den nächsten Handlungsschritt ab.
Orcha-3: Der Transfer in die Automatisierungstechnik
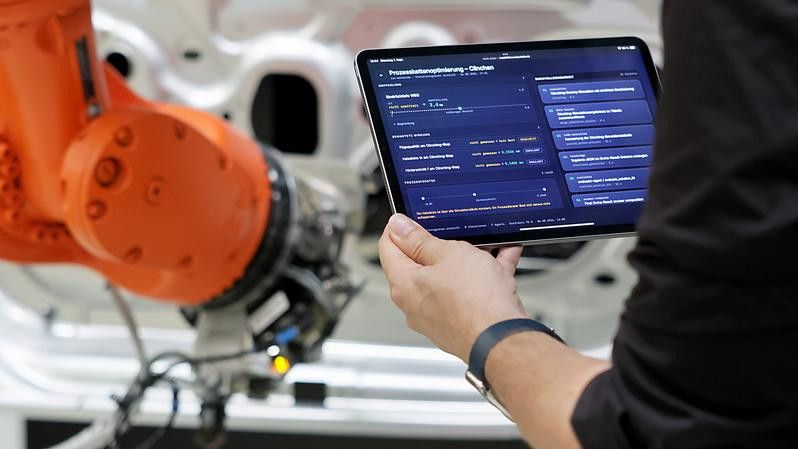
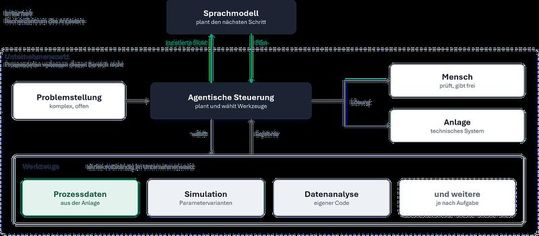
Orcha-3: Prinzipdarstellung.
(Bild: Fraunhofer IWU)
Mit der Plattform „Orcha-3“ hat das Fraunhofer-Institut für Werkzeugmaschinen und Umformtechnik IWU diesen Ansatz nun für die Produktionstechnik adaptiert. Die Plattform ist für offene Fragestellungen konzipiert, bei denen der nächste sinnvolle Analyseschritt erst feststeht, wenn der vorherige ausgewertet ist. Im Fall der unerklärlichen Maßabweichungen ruft Orcha-3 selbstständig Prozessdaten ab, führt Zeitreihen mehrerer Stationen zusammen, berechnet Korrelationen und simuliert Parametervariationen. Doch wie integriert sich ein solches System in die klassische Automatisierungspyramide? Dr.-Ing. Wolfgang Zorn, Geschäftsfeldleiter Adaptive Prozessketten am Fraunhofer IWU, ordnet ein: „Stand heute klinkt sich Orcha-3 nicht direkt in die Steuerungsebene ein, sondern eine Ebene darüber – dort, wo Prozessdaten bereits gesammelt vorliegen.“ Der Zugriff erfolgt über spezialisierte Agenten, beispielsweise auf Basis von HTTP. Über generische Agenten für REST-Schnittstellen lassen sich auch MES-Systeme anbinden. Ein nativer OPC-UA-Client ist aktuell noch nicht implementiert, stellt laut Zorn aber keine architektonische Hürde dar, sondern wäre lediglich ein weiterer deterministischer Agent, der bei Bedarf ergänzt werden kann.
Lokaler Server statt Edge-Computing
Physisch läuft Orcha-3 nicht direkt auf einem Edge-Gerät an der Maschine, sondern auf einem lokalen Linux-Server im Maschinennetz. Diese Architekturentscheidung hat praktische Gründe: Analyseläufe können mehrere Minuten dauern, greifen auf Daten verschiedener Stationen zu und müssen auch einen Neustart überstehen. Der Systemzustand wird daher im Dateisystem gespeichert. Für Anlagenbetreiber wichtig: Derzeit verlassen berechnete Parameter-Updates die Plattform lediglich als Empfehlung für den Menschen. Zwar ist Orcha-3 technisch in der Lage, Daten direkt an einen maschinennahen Endpunkt zu schreiben (Closed Loop), dies ist jedoch standardmäßig nicht scharfgeschaltet. Hierfür, so die Entwickler, bedarf es einer wasserdichten Freigabelogik, die individuell mit dem Anwender definiert werden muss.
Datensouveränität ohne On-Premise-GPU-Zwang
Ein häufiges Bedenken beim industriellen KI-Einsatz ist der Abfluss sensibler Prozessdaten, da diese oft den eigentlichen Wettbewerbsvorteil darstellen. Orcha-3 löst diesen Konflikt durch eine strikte Aufgabenteilung zwischen „Planung“ (Sprachmodell) und „Ausführung“ (Agenten). Überraschend dabei: Der „Planner“ ist standardmäßig ein cloudbasiertes Modell (aktuell Azure OpenAI). Ein teures On-Premise-GPU-Cluster muss der Betrieb dennoch nicht vorhalten, ein einfacher Linux-Server genügt. „Wir lösen die Frage der Datensouveränität also nicht über den Ort der Inferenz, sondern über die Architektur“, erklärt Dr. Zorn. „Das Modell entscheidet primär, welcher Schritt als nächstes sinnvoll ist und liefert diese Entscheidung als strukturierte Anweisung zurück. Es greift auf kein Produktionssystem zu.“
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
Sämtliche Datenbankabfragen, Berechnungen und Simulationen laufen lokal über die deterministischen Agenten ab. Das Sprachmodell in der Cloud erhält ausschließlich eine kuratierte Sicht: Zusammenfassungen, Kennzahlen und Dateipfade – ausdrücklich jedoch keine Rohdaten. Da diese kuratierte Sicht für jeden Planungsschritt deterministisch erzeugt und gespeichert wird, bleibt für Anwender auch Monate später lückenlos nachvollziehbar und überprüfbar, welche Informationen tatsächlich das Unternehmensnetz verlassen haben und wie eine Empfehlung zustande kam. Wer aus regulatorischen Gründen dennoch ein lokales Open-Source-LLM nutzen möchte, kann den zentralen Endpunkt umstellen – muss dann aber potenziell Abstriche bei der Planungsqualität in Kauf nehmen.
Bleibt die Frage der Bedienbarkeit: Wer konfiguriert das System für eine neue Produktionslinie? Auch hier gibt das Fraunhofer IWU Entwarnung. Während die eigentlichen digitalen Werkzeuge (die Agenten) deterministische Softwarebausteine mit festen Schnittstellen sind, die von Entwicklern programmiert werden, erfolgt die Anwendungsebene völlig ohne Programmierkenntnisse. Prozess- und Automatisierungsingenieure definieren die Leitplanken für die KI in Form von „Profilen“. Diese bestehen aus einer Werkzeugauswahl und Anweisungen in natürlicher Sprache. Ein Prozessverantwortlicher kann der KI einfache Text-Vorgaben machen, wie etwa: „Lies erst die aktuellen Sollwerte, bevor du neue vorschlägst“ oder „Sichere jeden Parametervorschlag durch eine entsprechende Simulation ab“. Innerhalb dieses Rahmens plant und arbeitet das System völlig eigenständig.
Nächster Schritt: Reale Fabrikhallen
Um das oft beklagte „Henne-Ei-Dilemma“ fehlender Daten zum Start zu umgehen, wurde Orcha-3 an virtuellen Prozessketten mit synthetisierten Daten erprobt und zur Funktionsreife gebracht. Nun sucht das Fraunhofer IWU den Transfer in die Industrie. Automatisierungsverantwortliche, die in ihren Werken mit ungeklärten Fehlerquellen in komplexen Prozessketten kämpfen, sind eingeladen, konkrete Aufgabenstellungen gemeinsam mit den Forschern auf ihre Machbarkeit mit dem Orcha-3-Ansatz zu evaluieren.